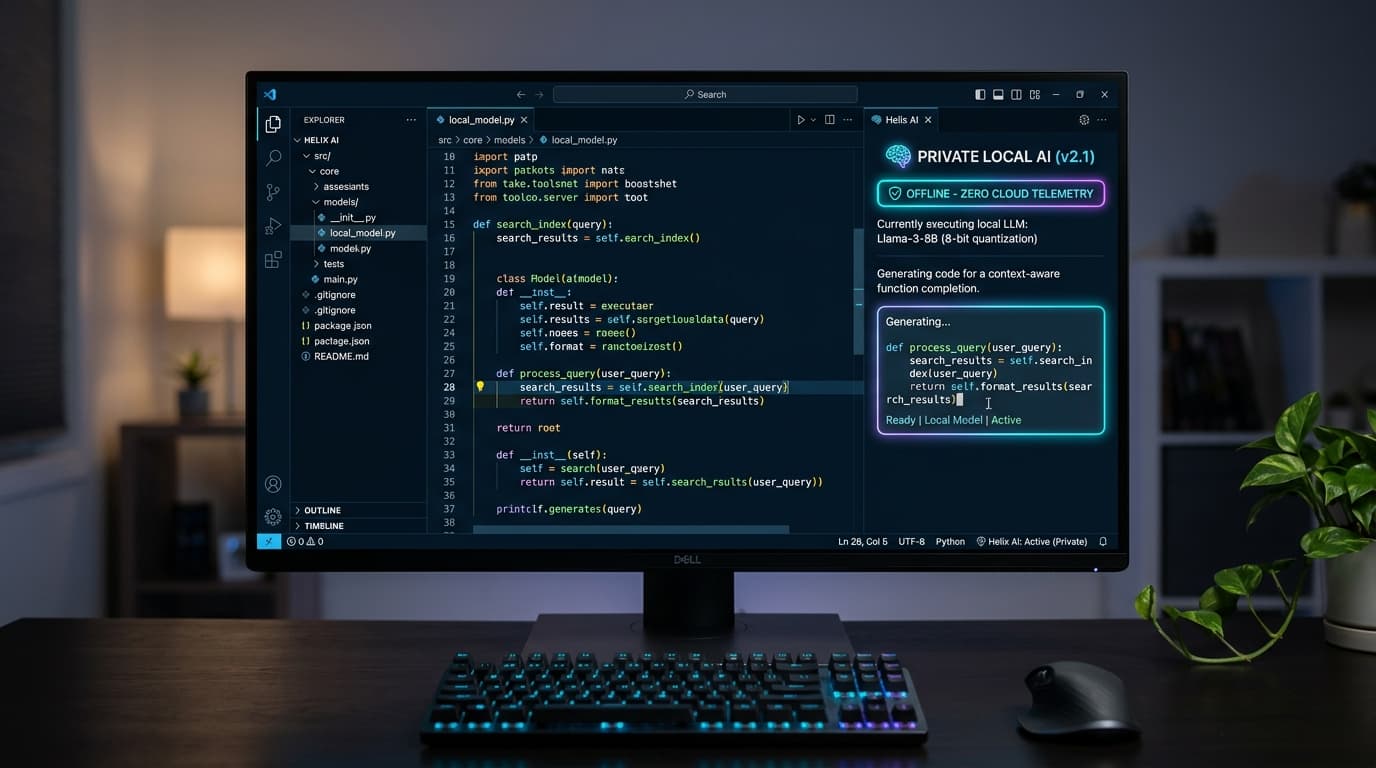
O uso de assistentes de inteligência artificial para desenvolvimento de software tornou-se um padrão indispensável para produtividade. No entanto, ferramentas proprietárias como o GitHub Copilot e Cursor trazem duas dores severas:
- Custos Recorrentes em Dólar: Mensalidades que encarecem a operação para desenvolvedores independentes e pequenos times;
- Risco de Conformidade e Vazamento de Dados: Códigos proprietários, chaves de API internas e dados de clientes sendo enviados para servidores na nuvem, violando diretrizes de LGPD e políticas corporativas.
Com o amadurecimento dos modelos de código abertos em 2026 — especialmente a arquitetura Qwen 2.5 Coder —, agora é perfeitamente viável ter um assistente equivalente rodando 100% offline no seu próprio computador.
Neste tutorial prático, você aprenderá a configurar a extensão Continue.dev no VS Code conectada ao Ollama para autocompletar inteligente via Tab e chat lateral com contexto do repositório.
1. A Arquitetura do Copilot Privado
┌─────────────────────────────────────────────────────────────┐
│                     VISUAL STUDIO CODE                      │
│                                                             │
│   ┌─────────────────────┐         ┌─────────────────────┐   │
│   │  Inline Completion  │         │   Painel de Chat    │   │
│   │    (Pressione Tab)  │         │      (Ctrl + L)     │   │
│   └──────────┬──────────┘         └──────────┬──────────┘   │
└──────────────┼───────────────────────────────┼──────────────┘
               │                               │
               ▼                               ▼
       EXTENSÃO CONTINUE.DEV (Cliente Local no VS Code)
                       │
                       ▼ Chamadas REST (http://localhost:11434)
            OLLAMA (Servidor de Inferência Local)
                       │
        ┌──────────────┴──────────────┐
        ▼                             ▼
  Qwen 2.5 Coder 1.5B           Qwen 2.5 Coder 7B
  (FIM / Baixa Latência)        (Chat & Refatoração)
2. Passo 1: Baixando os Modelos no Ollama
Abra o terminal e execute:
# Modelo ultra-leve e otimizado para Fill-In-the-Middle (autocompletar no editor)
ollama pull qwen2.5-coder:1.5b-base

# Modelo avançado para chat lateral, geração de testes e explicação de código
ollama pull qwen2.5-coder:7b
3. Passo 2: Configurando a Extensão Continue.dev
- Abra o VS Code e instale a extensão oficial Continue (
Continue.continue). - Abra o arquivo de configuração localizado em
~/.continue/config.json(ou clique no ícone de engrenagem no painel da extensão). - Insira o seguinte bloco de configuração:
{
  "models": [
    {
      "title": "Qwen 2.5 Coder 7B (Local)",
      "provider": "ollama",
      "model": "qwen2.5-coder:7b",
      "apiBase": "http://localhost:11434"
    }
  ],
  "tabAutocompleteModel": {
    "title": "Qwen 2.5 Coder 1.5B (Autocomplete)",
    "provider": "ollama",
    "model": "qwen2.5-coder:1.5b-base",
    "apiBase": "http://localhost:11434"
  },
  "customCommands": [
    {
      "name": "testes",
      "prompt": "Gere testes unitários abrangentes com mocks e casos extremos para o código selecionado.",
      "description": "Gerar testes unitários"
    },
    {
      "name": "docstring",
      "prompt": "Gere documentação em padrão Google/JSDoc detalhando parâmetros e retornos.",
      "description": "Gerar documentação"
    }
  ]
}
Salve o arquivo (Ctrl + S). A extensão recarrega as configurações automaticamente.
4. Recursos Avançados no Dia a Dia
- Autocompletar Contínuo: Conforme você escreve funções, o modelo analisa as linhas anteriores e posteriores e sugere a implementação completa. Pressione
Tabpara aceitar ouEscpara dispensar. - Referência de Contexto (@Files): No chat lateral (
Ctrl + L), digite@para indexar qualquer arquivo do projeto, permitindo que a IA entenda suas estruturas de tipos e contratos de API. - Edição no Local (
Ctrl + I): Destaque um trecho de código, pressioneCtrl + Ie digite: "Converta esta função para sintaxe assíncrona com tratamento de exceções". O modelo aplica o diff diretamente no editor.
Conclusão
Substituir ferramentas em nuvem por modelos locais não traz apenas economia de custos: traz soberania tecnológica e proteção absoluta de segredos corporativos.
Se você quer integrar IA sob medida aos sistemas e fluxos da sua empresa com segurança máxima, conheça os serviços da Vexis Agency. Fale com nossa equipe técnica e leve sua infraestrutura ao próximo nível.